Sự Chuyển Biến Nhận Thức: Từ Trình Xem Dữ Liệu Sang Bản Sao Số Thông Minh
Các cuộc thảo luận hiện nay về công nghệ bản sao số (digital twin) đang ở một bước ngoặt quan trọng. Khi các tổ chức cố gắng thu hẹp khoảng cách giữa thế giới thực và môi trường số, nhiều người nhận ra rằng nếu chỉ tạo ra một bản sao 3D (hình học) hay một bảng dữ liệu thì đó chẳng khác gì một “trình xem dữ liệu” cao cấp. Thiếu đi lớp ngữ nghĩa mà máy móc có thể hiểu được, những mô hình này chỉ là các kho chứa dữ liệu rời rạc, không có khả năng tự ra quyết định, phân tích dự đoán hay liên kết với các hệ thống khác. Việc tiến hóa từ bản sao số thông thường sang Bản Sao Số Thông Minh (Cognitive Digital Twin – CDT) đòi hỏi một sự thay đổi hoàn toàn về cách tổ chức, liên kết và truy vấn dữ liệu1.
Các kiến trúc truyền thống thường phụ thuộc vào các cơ sở dữ liệu quan hệ cứng nhắc hoặc các cấu trúc phân mảnh theo từng lĩnh vực. Lấy ví dụ: khi một van công nghiệp bị hỏng, bản sao số 3D có thể cho bạn biết van đó nằm ở đâu trong nhà máy, nhưng nó lại không hiểu được mối liên hệ giữa cái van này với hệ thống dòng chảy, lịch sử bảo trì trong hệ thống quản lý, hay dữ liệu cảm biến thời gian thực đang báo lỗi2. Mắt xích còn thiếu để kết nối những “hòn đảo” dữ liệu rời rạc này thành một bản sao thông minh, linh hoạt chính là các mối quan hệ ngữ nghĩa.
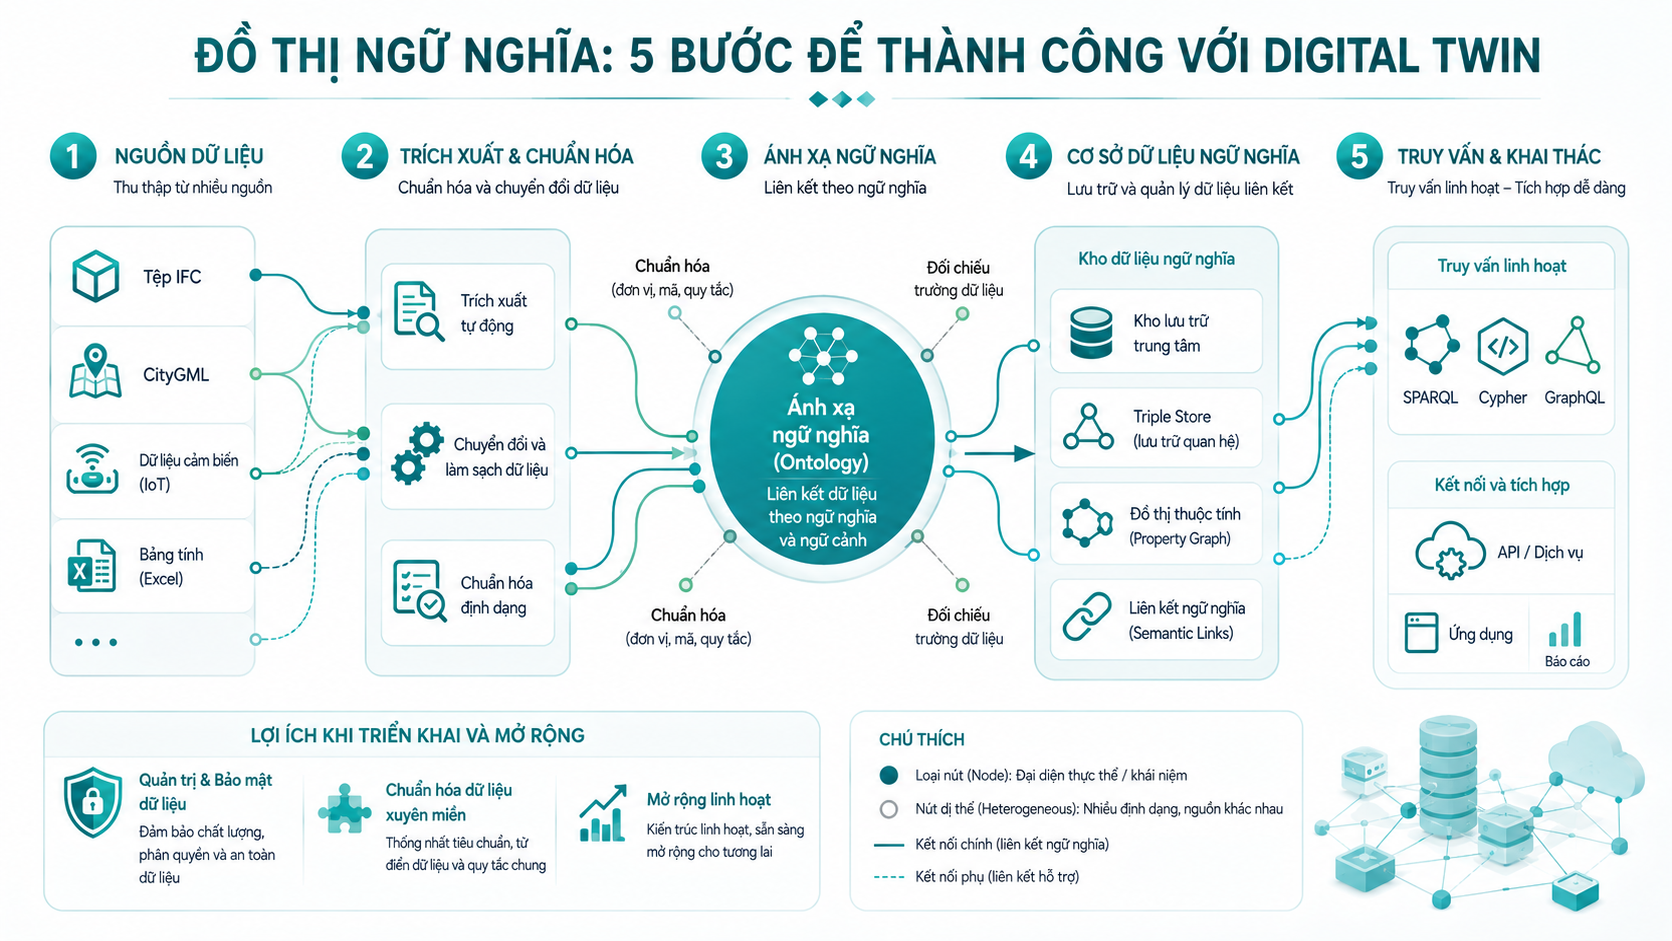
Bằng cách thống nhất các tiêu chuẩn dữ liệu chéo qua một kiến trúc Bản Sao Số Ngữ Nghĩa, các điểm dữ liệu rời rạc sẽ được biến thành một Đồ thị Tri thức (Knowledge Graph) liên kết chặt chẽ. Điều này tạo ra cách tiếp cận “Hệ thống của các Hệ thống” (System-of-Systems), trong đó nhiều hệ thống con độc lập có thể hoạt động cùng nhau nhờ các kết nối được định nghĩa rõ ràng qua các Mô hình Khái niệm (Ontology)1. Để hiện thực hóa tầm nhìn này, cần có một lộ trình bài bản. Việc xử lý dữ liệu thô qua một đường ống liên tục gồm 5 bước: trích xuất, ánh xạ mô hình, lưu trữ ngữ nghĩa và truy vấn tốc độ cao, sẽ đảm bảo bản sao số có thể trả lời các truy vấn đa liên kết phức tạp chỉ trong vài mili giây.
Bước 1 & 2: Nguồn Dữ Liệu Thô, Trích Xuất Tốc Độ Cao và Chuyển Đổi
Thách thức đầu tiên và lớn nhất là dữ liệu đầu vào cực kỳ đa dạng. Một bản sao số toàn diện phải tiếp nhận đủ loại dữ liệu: từ mô hình hình học 3D (IFC, CityGML), bảng tính tĩnh (Excel, cơ sở dữ liệu cũ), cho đến các luồng dữ liệu cảm biến IoT liên tục. Để gom tất cả vào một đồ thị duy nhất, ta cần các công cụ trích xuất và chuyển đổi đặc biệt, có khả năng đọc các cấu trúc phức tạp mà không làm quá tải bộ nhớ hay mất mát dữ liệu.
Giải Mã Khối Hình Học 3D: IFC, CityGML và Web-IFC
Trong ngành Kiến trúc, Kỹ thuật và Xây dựng (AEC), tiêu chuẩn IFC là lõi của Mô hình Thông tin Xây dựng (BIM). Tuy nhiên, các tệp IFC truyền thống thường rất cồng kềnh, chứa nhiều lớp thông tin lồng nhau và lặp lại, khiến chúng khó sử dụng trong các ứng dụng web động4.
Các công cụ như ifcopenshell và web-ifc đã trở thành tiêu chuẩn mới để giải quyết vấn đề này. Chúng bỏ qua các phương pháp kết xuất cứng nhắc cũ để trích xuất trực tiếp hình học và siêu dữ liệu (metadata) vào các định dạng tối ưu cho bộ nhớ6. Ví dụ, các đường ống dữ liệu hiện đại dùng web-ifc trên các máy chủ nhẹ để chuyển đổi mô hình IFC sang định dạng thân thiện với web như glTF, đồng thời rút trích thông tin ngữ nghĩa thành các đối tượng JSON hoặc bộ ba RDF (chủ ngữ – vị ngữ – bổ ngữ)4. Để tối ưu hơn nữa, các thuật toán nén như IFCCompressor giúp loại bỏ các chi tiết định nghĩa thừa, giảm dung lượng tệp đáng kể mà không làm mất thông tin5.
Đồng thời, các dữ liệu tĩnh từ bảng tính cũng phải được chuyển sang định dạng RDF. Các công cụ như RDFLib đóng vai trò lập trình để ánh xạ dữ liệu dạng bảng thành cấu trúc đồ thị mềm dẻo, trong đó mỗi thực thể có một định danh duy nhất (URI). Các khung làm việc tiên tiến còn tự động trích xuất ranh giới không gian (trần, tường, sàn) từ hình học thô để đưa trực tiếp vào đồ thị tri thức8.
Xử Lý Luồng Cảm Biến Thời Gian Thực (RSP)
Dữ liệu cảm biến IoT lại mang đến một thách thức khác: tốc độ đổ về quá nhanh. Các cơ sở dữ liệu ngữ nghĩa thông thường vốn chỉ quen lưu dữ liệu tĩnh, nếu bị nhồi nhét luồng dữ liệu MQTT liên tục, chúng sẽ bị nghẽn cục bộ9.
Để giải quyết, kiến trúc hiện đại triển khai các bộ xử lý luồng RDF (RSP). Các công cụ như CQELS và C-SPARQL có thể hứng trực tiếp dữ liệu từ MQTT, biến chúng thành các liên kết RDF ngay trên bộ nhớ tạm và truy vấn liên tục theo thời gian thực9. Các bài kiểm thử hiệu suất (như SRBench) cho thấy công cụ như CQELS có thể xử lý tới 5.000 điểm dữ liệu mỗi giây trên các thiết bị biên (edge) nhỏ gọn mà vẫn giữ độ trễ dưới 100 mili giây11.
Sự đánh đổi ở đây là về mặt thời gian. CQELS có độ trễ cực thấp nhưng có thể bỏ qua các dữ liệu đến muộn, trong khi C-SPARQL đảm bảo không sót dữ liệu nào nhưng trễ hơn một chút khi dữ liệu dồn về đột ngột12. Bằng cách đẩy quy trình xử lý này ra các thiết bị biên gần nguồn phát, độ trễ mạng giảm xuống mức tối thiểu, giúp hệ thống đủ nhanh để đưa ra các cảnh báo tự động trong nhà máy hoặc quản lý thành phố thông minh theo thời gian thực.
Bước 3: Ánh Xạ Mô Hình (Ontology), Chuẩn Hóa và Tính Toàn Vẹn Cấu Trúc
Sau khi trích xuất, dữ liệu phải được chuẩn hóa chung một “ngôn ngữ”. Nếu không có bộ từ vựng chung, đồ thị tri thức sẽ chỉ là một mớ hỗn độn. Bước 3 yêu cầu ánh xạ dữ liệu vào các mô hình chuẩn (Ontology) như ifcOWL hay Brick để hệ thống có thể mở rộng dễ dàng.
Khủng Hoảng Phình To Dữ Liệu và Giải Pháp Tối Giản
Nỗ lực đầu tiên của ngành xây dựng là dùng mô hình ifcOWL, dịch trực tiếp cấu trúc của tệp IFC. Dù rất chi tiết, mô hình này lại là thảm họa cho tốc độ của bản sao số. Nó chứa hơn 1.200 nhóm phân loại và 1.500 loại quan hệ chồng chéo13. Vì cố mô tả cả những điểm tọa độ 3D siêu nhỏ thành các liên kết ngữ nghĩa, ifcOWL làm dữ liệu phình to theo cấp số nhân, gây tràn bộ nhớ và làm tê liệt các truy vấn thời gian thực5.
| Khung Mô hình (Ontology) | Trọng tâm Mô hình hóa | Độ phức tạp & Chi tiết | Ứng dụng Tối ưu cho Bản sao số |
| ifcOWL | Dịch trực tiếp từ chuẩn IFC EXPRESS | Rất cao (1200+ lớp). Gây phình to dữ liệu nặng nề. | Lưu trữ tương thích; trao đổi dữ liệu tĩnh toàn diện. |
| BOT (Building Topology) | Mối quan hệ không gian và hình học | Tối giản (7 lớp, 14 quan hệ). Dễ mở rộng và chia mô-đun. | Làm “xương sống” không gian để liên kết các dữ liệu khác. |
| Brick Schema | Quản lý tòa nhà (BMS) và IoT | Trung bình. Tập trung vào hệ thống HVAC và cảm biến. | Ánh xạ cảm biến thời gian thực; phân tích lỗi tự động. |
| RealEstateCore | Quản lý bất động sản thương mại | Trung bình. Tập trung vào vận hành, cho thuê. | Quản lý danh mục đầu tư; ứng dụng cho người thuê tòa nhà. |
| SAREF4BLDG | Thiết bị thông minh | Trung bình. Mở rộng định nghĩa cảm biến IoT trong không gian. | Giám sát thiết bị chi tiết; tích hợp nhà thông minh. |
Để khắc phục, ngành công nghiệp đã chuyển sang các mô hình tối giản hơn, bỏ qua chi tiết hình học để tập trung vào mối quan hệ thực tế. Mô hình Không gian Xây dựng (BOT) được dùng làm xương sống chính18. BOT cực kỳ tối giản, chỉ có 7 lớp lõi (Khu đất, Tòa nhà, Tầng, Không gian, Thiết bị…) để định nghĩa cái gì chứa trong cái gì13.
Nhờ lấy BOT làm gốc, ta có thể gắn các mô hình chuyên biệt khác vào. Ví dụ, mô hình Brick rất giỏi trong việc định nghĩa máy lạnh (HVAC) và cảm biến20. Khi ghép BOT và Brick, hệ thống sẽ tự hiểu một cảm biến nhiệt độ (định nghĩa bởi Brick) được lắp trong một căn phòng cụ thể (định nghĩa bởi BOT)22. Cách kết nối linh hoạt này giúp bản sao số chuyển từ một bản vẽ tĩnh thành một công cụ vận hành sống động4.
Đảm Bảo Tính Chính Xác Bằng SHACL
Khi gom dữ liệu từ nhiều nguồn, nguy cơ dữ liệu bị mâu thuẫn là rất cao. Vì dữ liệu đồ thị không có bảng biểu cố định, ta cần ngôn ngữ Ràng buộc Hình dạng (SHACL) để đặt ra luật (ví dụ: mỗi thiết bị chỉ được có một ngày sản xuất)23.
Tuy nhiên, việc dùng hệ thống suy luận tự động để kiểm tra SHACL trên toàn bộ bản sao số thường tốn quá nhiều tài nguyên, tạo ra hàng triệu liên kết rác và làm chậm hệ thống18. Giải pháp hiện nay là dùng công nghệ Re-SHACL, chỉ quét và gộp những thực thể liên quan trực tiếp đến quy tắc cần kiểm tra, thay vì quét toàn bộ đồ thị. Nhờ đó, dữ liệu được giữ sạch sẽ, chính xác mà không làm hy sinh tốc độ18.
Bước 4 & 5: Cơ Sở Dữ Liệu Tập Trung Và API Truy Vấn
Bước 4 và 5 yêu cầu lưu trữ toàn bộ dữ liệu đã được chuẩn hóa này vào một cơ sở dữ liệu ngữ nghĩa trung tâm, sẵn sàng cho các lệnh gọi API. Ở đây, các kiến trúc sư phần mềm phải chọn giữa hai thế giới: Lưu trữ Ba thành phần (RDF Triplestore) hay Đồ thị Thuộc tính (LPG). Sự lựa chọn này chính là câu trả lời cho việc: Bản sao số của bạn có thể trả lời nhanh trong mili giây không?
Ngã Rẽ Kiến Trúc: RDF Triplestore và Labeled Property Graphs (LPG)
Các cơ sở dữ liệu RDF (như Ontotext GraphDB, Stardog) lưu dữ liệu dưới dạng các câu 3 phần rời rạc (Ví dụ: Cảm biến A -> Nằm ở -> Phòng B). Điểm mạnh tuyệt đối của nó là sự tương thích liên ngành và khả năng suy luận logic theo tiêu chuẩn quốc tế26.
Tuy nhiên, RDF có một điểm yếu chí mạng: Tốc độ. Vì thông tin bị chẻ quá nhỏ, khi muốn tìm chuỗi liên kết dài (ví dụ: Cảm biến -> Phòng -> Tầng -> Hệ thống điện -> Lưới điện thành phố), hệ thống phải thực hiện hàng ngàn phép nối (join) rất nặng. Khi vượt qua mức 3 bước nhảy (hop), thời gian truy vấn thường tăng từ vài mili giây lên đến vài phút, tạo ra hiện tượng “bức tường độ sâu”28.
Ngược lại, Đồ thị Thuộc tính LPG (như Neo4j, Memgraph, TigerGraph) sinh ra để giải quyết tốc độ. Nó lưu trữ dữ liệu theo kiểu liền kề không cần chỉ mục (index-free adjacency)30. Trong cấu trúc này, mỗi nút dữ liệu được lưu kèm con trỏ địa chỉ bộ nhớ trỏ thẳng đến các nút hàng xóm31. Việc nhảy từ nút này sang nút khác tốn thời gian cố định O(1) bất kể kích thước đồ thị lớn đến đâu. Nhờ vậy, ngay cả khi cơ sở dữ liệu có hàng tỷ nút, truy vấn 5 bước nhảy vẫn chỉ mất vài mili giây31.
Vượt Qua “Bức Tường Độ Sâu”
Các bài kiểm tra tốc độ thực tế đã chứng minh rõ sự khác biệt này. Khi tìm kiếm nguyên nhân gốc rễ trong một mạng lưới phức tạp (từ 3 đến 7 bước nhảy), các engine LPG chuyên dụng trả kết quả chỉ trong vài chục mili giây, trong khi các hệ thống truyền thống chưa tối ưu có thể mất đến hàng giờ29.
Lấy ví dụ với một bài kiểm tra 6 bước nhảy phức tạp: hệ thống tối ưu hoàn thành trong 82 mili giây, trong khi hệ thống không được tối ưu mất hơn 43 giờ vì tràn bộ nhớ29.
| Loại Truy vấn (Bài kiểm tra) | CSDL Đồ thị Tối ưu Tốc độ Cao | CSDL Đồ thị Tiêu chuẩn | Mức tăng Hiệu suất |
| Nhảy 3 bước (người dùng đơn) | 13 ms | 12.2 s | ~939 lần |
| Nhảy 4 bước (người dùng đơn) | 29 ms | 366 s (6.1 phút) | ~12.759 lần |
| Nhảy 6 bước (người dùng đơn) | 54 ms | 110 s (1.8 phút) | ~2.039 lần |
| Nhảy 6 bước (tất cả người dùng) | 82 ms | 158.023 s (1.83 ngày) | ~1.936.558 lần |
Dữ liệu từ các bài kiểm tra thực tế cho thấy sự cố suy giảm hiệu suất hàm số mũ khi tra cứu sâu trên các cấu trúc chưa tối ưu29.
Kiến Trúc Lai: Đồ Thị Thuộc Tính Ngữ Nghĩa
Việc phải chọn giữa RDF (chuẩn hóa tốt) và LPG (tốc độ nhanh) khiến nhiều kiến trúc sư đau đầu. Giải pháp hoàn hảo hiện nay là Đồ thị Thuộc tính Ngữ nghĩa (Semantic Property Graph)35.
Hệ thống lai này lấy các quy tắc chuẩn hóa của RDF (như BOT, Brick) làm màng lọc đầu vào để đảm bảo tính nhất quán, nhưng lại lưu trữ dữ liệu dưới cấu trúc LPG lõi để tận dụng tốc độ tìm kiếm O(1) . Khi được thử nghiệm với mô hình chuyên dụng cho bản sao số, kiến trúc lai này tỏ ra vượt trội so với mọi hệ thống thông thường, xử lý gọn gàng các hệ thống không gian sâu thẳm mà không bị nghẽn mạng.
Ngôn Ngữ Truy Vấn: SPARQL, Cypher và GraphQL
Bước cuối cùng là giao tiếp với thế giới bên ngoài thông qua các API.
SPARQL: Là tiêu chuẩn vàng của W3C dành cho RDF, cực kỳ mạnh mẽ để suy luận học thuật và mô hình hóa28. Tuy nhiên, viết lệnh cho các đường dẫn biến đổi độ dài khá phức tạp và phụ thuộc nhiều vào bộ tối ưu hóa của máy chủ37.
Cypher và GQL: Được thiết kế bằng nghệ thuật ASCII (ví dụ: (Nút)-[QUAN_HỆ]->(Nút)), khiến nó cực kỳ trực quan và thân thiện với lập trình viên31. Nó sinh ra để tìm kiếm độ sâu trong bản sao số. GQL hiện đã là tiêu chuẩn toàn cầu (ISO/IEC 39075:2024), giúp mã lập trình có thể mang đi chạy trên nhiều hãng phần mềm khác nhau.
GraphQL: Dù không sinh ra cho cơ sở dữ liệu đồ thị, nó tạo ra một lớp API cực kỳ thân thiện cho các nhà phát triển web và di động39. Bằng cách nhúng lệnh Cypher vào GraphQL, ta mang lại sức mạnh của bản sao số cho các ứng dụng thông thường mà lập trình viên frontend không cần học cách viết truy vấn đồ thị phức tạp40. Cuối cùng, với các thiết bị thời gian thực, ta mở các cổng API cho bộ xử lý luồng (như CQELS), đảm bảo rằng khi một cảm biến IoT báo lỗi, hệ thống sẽ phát hiện ra vấn đề và kích hoạt giải pháp trong chớp mắt2.
Kiểm Chứng Quy Mô Đô Thị: Dự Án Thành Phố Thông Minh TP. Hồ Chí Minh
Mô hình 5 bước trên không chỉ nằm trên lý thuyết, mà đang được chứng minh tính hiệu quả qua các siêu dự án đô thị. Đô thị là một “Hệ thống của các Hệ thống” khổng lồ, đòi hỏi phản hồi cực nhanh trong tính toán. Dự án phát triển thành phố thông minh tại TP. Hồ Chí Minh (HCMC) là minh chứng sinh động nhất.
Theo Quyết định số 4714/QĐ-UBND, TP.HCM đã phê duyệt kế hoạch thành phố thông minh giai đoạn 2026-2030, hướng đến top 50 thành phố thông minh toàn cầu vào năm 2030 và vươn tầm cao nhất vào năm 204542. Trọng tâm của kế hoạch này là ngừng mua sắm công nghệ một cách phân mảnh, chuyển sang quản trị hoàn toàn dựa trên dữ liệu và công nghệ bản sao số42.
Hợp Nhất GIS, BIM và CIM
Trái tim của chiến lược này là việc hợp nhất Hệ thống Thông tin Địa lý (GIS) và Mô hình Thông tin Xây dựng (BIM) để tạo ra Mô hình Thông tin Thành phố (CIM)44. Trước đây, hai hệ thống này luôn bị tách rời: GIS lo không gian rộng lớn bên ngoài (đất đai, tọa độ), còn BIM lo không gian bên trong (hệ thống điện nước tòa nhà)44. Nhờ dùng chung chuẩn mô hình ngữ nghĩa (CityGML cho GIS và IFC/BOT cho BIM), rào cản này đã bị phá vỡ.
TP.HCM hiện đã có Bản đồ số với hơn 200 lớp dữ liệu GIS46. Khi áp dụng kế hoạch 5 bước, một cảm biến ngập lụt (kết nối qua hệ thống IoT) có thể gọi lệnh truy vấn chạy xuyên qua hệ thống không gian đô thị (BOT) để lập tức khoanh vùng ga tàu điện ngầm đang bị đe dọa. Dù vẫn còn rào cản về dữ liệu bị phân mảnh và vướng mắc pháp lý đất đai47, việc chuẩn hóa dữ liệu thông qua mô hình đồ thị ngữ nghĩa (Bước 3) đang dần giúp hệ thống quản lý có cái nhìn đồng bộ, bao quát hơn.
Hệ Thống Cảm Biến Metro, AI và Dự Án DT15
Hệ thống tàu điện ngầm Metro TP.HCM dự kiến đạt 200km vào năm 203048, quy tụ vô số hệ thống phức tạp từ điều độ giao thông (SCADA), vé điện tử, hệ thống điện đến cửa chắn nền tảng47. Ban Quản lý Đường sắt Đô thị (MAUR) đang triển khai công nghệ Digital Twin và IoT để xây dựng Trung tâm Điều hành Mạng lưới (OCC)47. Sử dụng đồ thị thuộc tính (Bước 4) giúp OCC thu nhận luồng dữ liệu liên tục từ tàu, so sánh chéo với mô hình bảo trì tĩnh và ngay lập tức tính toán ra phương án định tuyến an toàn.
Bên cạnh đó, với hơn 1.300 camera AI phục vụ giao thông50, dữ liệu ùn tắc sẽ được đẩy liên tục vào đồ thị để tự động thay đổi lộ trình của mạng lưới đèn tín hiệu. Các dự án dân sự ấn tượng như “DT15” của CT Group đang đưa vào thử nghiệm một bản sao sống động xây dựng từ 15 lớp dữ liệu đa dạng (không gian, mặt đất, mặt nước, ngầm…)51. Thay vì bị kẹt trong 15 bảng cơ sở dữ liệu quan hệ, đồ thị thuộc tính ngữ nghĩa giúp kết nối tất cả, tìm đường truyền tin đa lớp trong vài mili giây.
Quản Trị Mạng Lưới Dữ Liệu
Thách thức lớn nhất không nằm ở công nghệ, mà là ở tổ chức. Lãnh đạo TP.HCM xác định dữ liệu không chỉ là để “lưu trữ”, mà phải biến thành “dịch vụ”52. Quyết định 1293/QĐ-UBND đã đề ra kiến trúc dữ liệu 7 lớp, bao trùm từ hạ tầng, nguồn cấp, chia sẻ, lưu trữ đến bảo mật và quản trị.
Việc gắn các nguồn gốc dữ liệu trực tiếp vào các liên kết trong đồ thị giúp bản sao số biết chính xác thông tin được cấp bởi cảm biến nào, hay của phòng ban nào. Kết hợp với các bộ quy tắc kiểm định như Re-SHACL, nền tảng trao đổi dữ liệu có thể loại bỏ dữ liệu rác ngay từ cổng vào, đảm bảo rằng đồ thị tri thức của thành phố luôn là một tài sản chiến lược đáng tin cậy.
Tổng Kết: Chuẩn Hóa Dữ Liệu Liên Lĩnh Vực – Chìa Khóa Của Khả Năng Mở Rộng
Nhận định rằng “Bản sao số thiếu các mối quan hệ ngữ nghĩa thì chỉ là một trình xem dữ liệu cao cấp” là hoàn toàn chính xác. Nếu không có khả năng hiểu nhân quả, kế thừa thuộc tính hay dò tìm đường dẫn không gian, bản sao số thực chất vẫn bị “mù”.
Kế hoạch 5 bước kiến trúc Bản Sao Số Ngữ Nghĩa đưa ra một lời giải triệt để. Bằng cách lọc dữ liệu qua các bộ dịch thuật như web-ifc (Bước 1 & 2) và ánh xạ chúng vào các mô hình gọn nhẹ như BOT, Brick (Bước 3), chúng ta loại bỏ được sự cồng kềnh của dữ liệu truyền thống.
Quan trọng nhất, lưu trữ tất cả trên một hệ cơ sở dữ liệu lai (Semantic Property Graph) và xuất ra qua các cổng giao tiếp SPARQL hay GraphQL (Bước 4 & 5) mang lại cho chúng ta sức mạnh của cả hai thế giới: Tính chuẩn hóa khắt khe của Đồ thị Tri thức, và tốc độ siêu tốc O(1) của hệ cơ sở dữ liệu Đồ thị.
Nhìn vào những thực tiễn như siêu đô thị thông minh tại TP. Hồ Chí Minh, ta thấy chuẩn hóa dữ liệu chéo không chỉ là việc tối ưu công nghệ (IT), mà là nền móng bắt buộc để vận hành mọi cơ sở hạ tầng tương lai. Khi ngừng vật lộn với các giới hạn cấu trúc dữ liệu cũ và chủ động chuẩn hóa nó, chúng ta đang thực sự đánh thức bản sao số trở thành một thực thể sống động, thông minh và đầy tự chủ.
Nguồn tham khảo
- Cognitive Digital Twins: A Systematic Review of Definitions … – MDPI, https://www.mdpi.com/2078-2489/17/6/556
- Complex Network Modelling and Knowledge Graphs for Digital, https://easychair.org/publications/preprint/rDMv/open
- Semantic interoperability for digital twin-driven product development, https://www.tandfonline.com/doi/full/10.1080/27525783.2026.2618294
- Enhancing the ifcOWL ontology with an alternative representation, https://www.researchgate.net/publication/315960602_Enhancing_the_ifcOWL_ontology_with_an_alternative_representation_for_geometric_data
- A content-based compression algorithm for optimizing Industry, https://www.researchgate.net/publication/268883460_IFCCompressor_A_content-based_compression_algorithm_for_optimizing_Industry_Foundation_Classes_files
- Web3 Services for Information Exchange in the Construction Site, https://bimaplus.org/wp-content/uploads/2023/10/17-2023-GabrielVeloso.pdf
- BIM Computationnel, Des Données | PDF – Scribd, https://www.scribd.com/document/770789522/BIM-computationnel-des-donnees
- A Fully Automated DM-BIM-BEM Pipeline Enabling Graph-Based, https://arxiv.org/html/2601.16813v2
- From Opaque Streams to Explainable Systems: Semantic MQTT, https://www.mdpi.com/1999-5903/18/7/334
- Final_Front 3_17.8 (ko sửa), https://dost.hochiminhcity.gov.vn/documents/695/Final_SmartCities2018.pdf
- (PDF) SRBench: A Streaming RDF/SPARQL Benchmark, https://www.researchgate.net/publication/257030063_SRBench_A_streaming_RDFSPARQL_benchmark
- Autonomous RDF Stream Processing for IoT Edge Devices, https://www.researchgate.net/publication/339250202_Autonomous_RDF_Stream_Processing_for_IoT_Edge_Devices
- Multiple inheritance for a modular BIM – OSArch Community, https://community.osarch.org/uploads/editor/a0/1se97k6z8n3v.pdf
- bhOWL: BHoM and Semantic Web Technologies, https://linkedbuildingdata.net/ldac2023/files/presentations/230616-LDAC%20conference.pdf
- 30. Forum Bauinformatik – www.smarsly.de, https://smarsly.de/wp-content/uploads/2018/09/fbi2018_konferenzband.pdf
- A Survey on Semantic Modelling for Building Energy Management, https://arxiv.org/html/2404.11716v2
- Research Companion To Building Information Modeling – 2022, https://www.scribd.com/document/624635285/Research-Companion-to-Building-Information-Modeling-2022
- The building topology ontology of the W3C linked building data group, https://www.karlancer.com/api/file/1637500158-Ctrc.pdf
- Exploring the application of graph neural networks for design review, https://pure.tue.nl/ws/files/307935717/1-s2.0-S1474034623002653-main.pdf
- A Systematic Comparison and Evaluation of Building Ontologies for, https://arxiv.org/html/2603.14374v3
- Metadata Schemas and Ontologies for Building Energy Applications, https://www.mdpi.com/1996-1073/14/7/2024
- Towards Aligning Domain Ontologies with the Building Topology, https://www.researchgate.net/publication/320878270_Towards_Aligning_Domain_Ontologies_with_the_Building_Topology_Ontology
- What is SHACL? – Oxford Semantic Technologies, https://www.oxfordsemantic.tech/faqs/what-is-shacl
- Efficient Validation of SHACL Shapes with Reasoning, https://www.vldb.org/pvldb/vol17/p3589-acosta.pdf
- SHACL in gdotv: Unifying Your RDF Data Model & Validation, https://gdotv.com/blog/shacl-gdotv-unify-graph-data-model-validation/
- RDF vs Property Graph – Semantic Partners, https://www.semanticpartners.com/learn/rdf-vs-property-graph
- Property Graph vs RDF: Graph Model Comparison | TigerGraph, https://www.tigergraph.com/blog/property-graph-vs-rdf/
- Knowledge System Architecture: Design Patterns and Frameworks, https://knowledgesystemsauthority.com/knowledge-system-architecture/
- Beyond the Depth Wall: Solving Deep Graph Traversal – Data Graphs, https://datagraphs.com/blog/beyond-the-depth-wall-solving-deep-graph-traversal
- A Comparative Analysis of Modern Graph Database Systems – Uplatz, https://uplatz.com/blog/a-comparative-analysis-of-modern-graph-database-systems/
- Neo4j Interview Questions and Answers – GoodSpace AI, https://goodspace.ai/interview-questions/neo4j
- GraphDB vs Neo4j: Key Differences Explained – PuppyGraph, https://www.puppygraph.com/blog/graphdb-vs-neo4j
- I benchmarked 5 managed graph databases — and the “obvious, https://dev.to/ahmed_amer/i-benchmarked-5-managed-graph-databases-and-the-obvious-winner-changed-depending-on-what-i-4i4i
- Graph Database Benchmarks: ArcadeDB vs Neo4j & LDBC Results, https://arcadedb.com/benchmarks.html
- Scaling Knowledge Graphs for Automating AI of Digital Twins, https://iswc2022.semanticweb.org/wp-content/uploads/2022/11/978-3-031-19433-7_46.pdf
- SPARQL vs Cypher: Key Differences Explained – PuppyGraph, https://www.puppygraph.com/blog/sparql-vs-cypher
- Graph Databases for Enterprise AI: A Practical Guide to Scaling, https://www.brash.pro/posts/graph-databases-for-enterprise-ai-a-practical-guide-to-scaling-knowledge
- RDF triple stores vs. property graphs: What’s the difference? – Neo4j, https://neo4j.com/blog/knowledge-graph/rdf-vs-property-graphs-knowledge-graphs/
- Graph Database Query Languages You Should Try – Memgraph, https://memgraph.com/blog/graph-database-query-languages-you-should-try
- Introduction to Graph Query Languages. From SPARQL to Gremlin., https://graph.build/resources/graph-query-languages
- What is an Enterprise Knowledge Graph? Use Cases in Agentic AI, https://www.superblocks.com/blog/enterprise-knowledge-graph
- Ho Chi Minh City approves Smart City Development Plan for 2026, https://www.hochiminhcity.gov.vn/vi/web/hcm-eng/-/ho-chi-minh-city-approves-smart-city-development-plan-for-2026-2030
- Ho Chi Minh City targets global Top 50 smart cities by 2030, https://vietnamnet.vn/en/ho-chi-minh-city-targets-global-top-50-smart-cities-by-2030-2501579.html
- Enhancing the administration of urban planning: A crucial factors in, https://www.growingscience.com/dsl/Vol15/dsl_2026_46.pdf
- 3D/360 Smart Interactive City – StarGlobal 3D, https://starglobal3d.com/en/smart-city-360
- Ho Chi Minh City aims to become a global smart city – Vietnam, https://en.nhandan.vn/ho-chi-minh-city-aims-to-become-a-global-smart-city-post160834.html
- Ho Chi Minh City cooperates with businesses under the Ministry of, https://news.laodong.vn/xa-hoi/tphcm-hop-tac-voi-doanh-nghiep-thuoc-bo-cong-an-de-nghien-cuu-phat-trien-cong-nghe-metro-1736711.ldo
- HCMC links metro infrastructure investment with technology mastery, https://en.sggp.org.vn/hcmc-links-metro-infrastructure-investment-with-technology-mastery-post128074.html
- President Ho Chi Minh’s special aircraft on display at National, https://en.baoquocte.vn/president-ho-chi-minhs-special-aircraft-on-display-at-national-achievement-exhibition-328409.html
- AI, Digital Twin technology underpin Việt Nam smart city development, https://vietnamnews.vn/economy/1781240/ai-digital-twin-technology-underpin-viet-nam-smart-city-development.html
- TECHNOLOGY COMPANIES OFFER INITIATIVES TO DRIVE A GDP, https://ctgroupvietnam.com/en/technology-companies-offer-initiatives-to-drive-a-gdp-breakthrough-for-ho-chi-minh-city/
- HCMC to turn data into core growth engine for digital economy, https://en.sggp.org.vn/hcmc-to-turn-data-into-core-growth-engine-for-digital-economy-expansion-post127198.html


